표를 처음 보는 사람도 어떤 숫자가 어떤 항목에 속하는지 금방 알아챕니다. 줄이 끊겨 있어도, 칸이 합쳐져 있어도 마찬가지입니다. 문서 이해 연구팀 한서윤 연구원이 이 당연한 능력을 기계에게 가르치며 겪은 이야기를 적었습니다.
글자를 다 읽어도 표는 모른다
초기 모델은 표 안의 글자를 거의 정확하게 읽었습니다. 그런데 추출 결과를 보면 ‘상환 기간’ 옆에 ‘대출 금액’의 숫자가 붙어 있었습니다. 글자는 맞게 읽었지만 어떤 칸에 속하는지를 틀린 것입니다. 우리는 이 오류가 실제 현장에서 가장 자주, 가장 비싸게 발생한다는 것을 알게 되었습니다.
줄에 기대지 않기
처음에는 표의 선을 찾아 칸을 나누는 방법을 썼습니다. 깨끗한 문서에서는 잘 동작했지만 팩스로 들어온 서류는 선이 끊겨 있었고, 요즘 서식은 아예 선 없이 여백으로만 칸을 구분하기도 합니다. 선에 기대는 한 이 문제를 풀 수 없었습니다.
관계로 생각하기
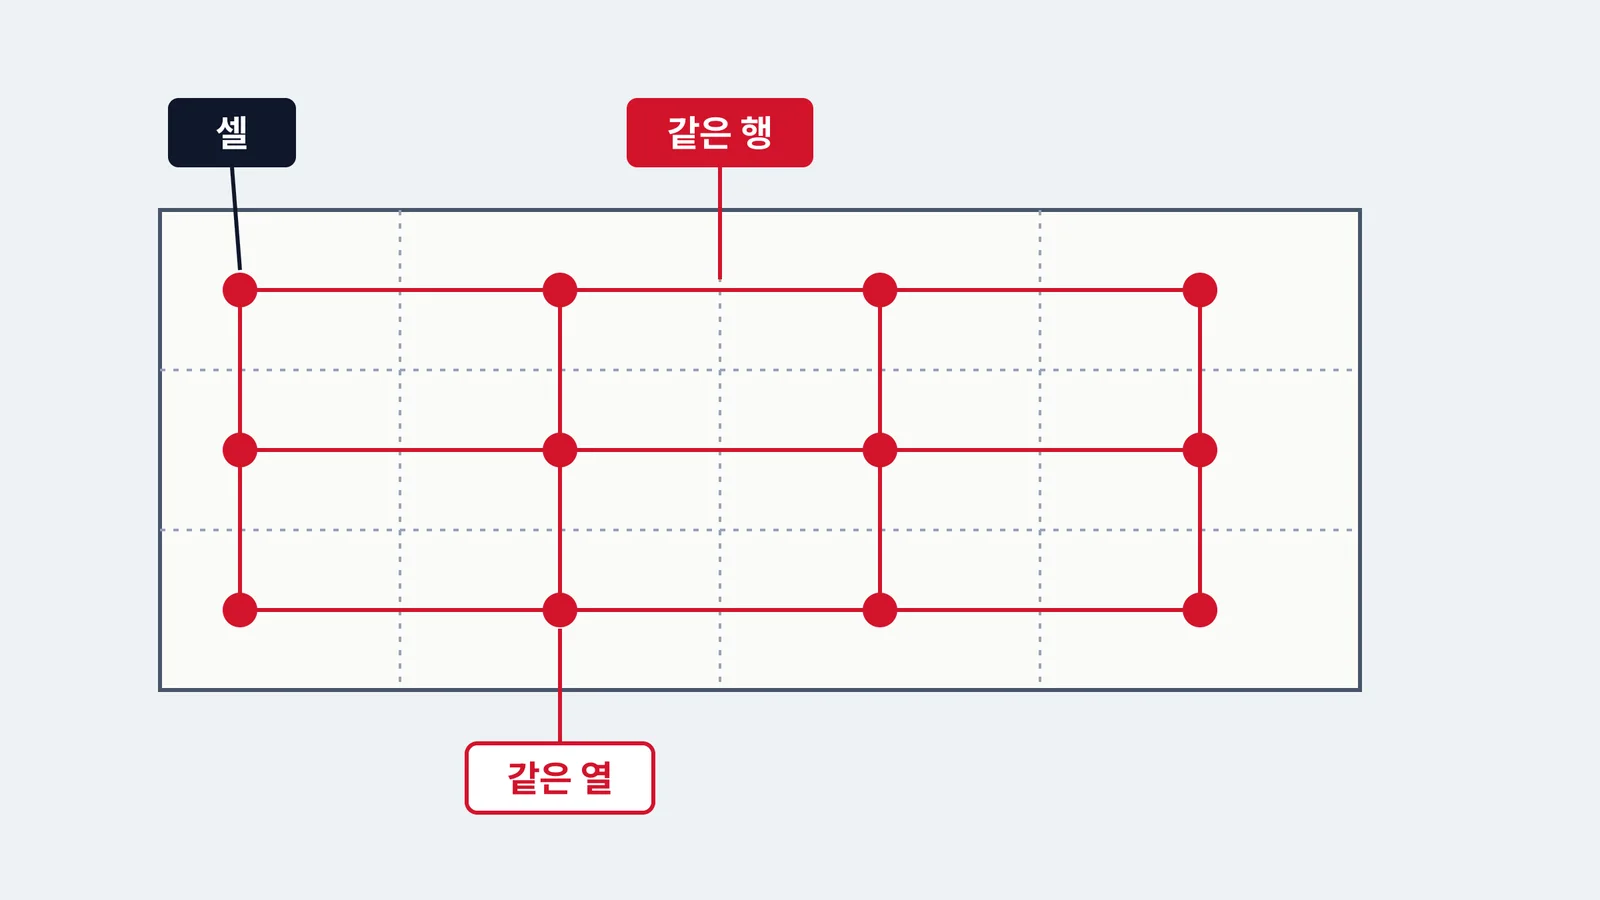
그래서 질문을 바꿨습니다. ‘선이 어디 있나’가 아니라 ‘이 글자 덩어리와 저 글자 덩어리는 같은 줄에 있나’를 묻기로 했습니다. 글자 덩어리를 점으로, 같은 줄이나 같은 열에 있을 가능성을 선으로 그리면 표는 하나의 그래프가 됩니다. 강하게 이어진 점들을 묶으면 행과 열이 나오고, 두 묶음에 걸친 점은 병합된 칸이 됩니다.
아직 어려운 것
여러 페이지에 걸친 표, 한 칸에 겹쳐 쓴 손글씨는 여전히 어렵습니다. 자세한 실험 조건과 결과는 기술 리포트 GR-2026-08에 정리했습니다.