4비트 양자화 이후 한국어 문서 모델의 정확도 손실 측정
임도하, 강민재, 한서윤
기술 리포트 · GR-2026-072026.07.15
요약
문서 이해 모델을 휴대 스캐너와 키오스크에 올리려면 크기를 크게 줄여야 합니다. 본 리포트는 한국어 문서 모델을 8비트와 4비트로 양자화했을 때 항목 추출 정확도가 어떤 층에서 얼마나 떨어지는지 측정하고, 손실이 큰 층만 원래 정밀도로 남기는 혼합 방식의 결과를 정리합니다(예시 데이터).
작게 만들면 무엇을 잃는가
경량화 결과를 이야기할 때 흔히 모델 크기와 속도만 강조합니다. 하지만 업무 현장에서 중요한 것은 줄어든 모델이 어떤 문서, 어떤 항목에서 틀리기 시작하는지입니다. 이 리포트는 그 질문에 답하기 위해 작성했습니다.
측정 방법
가늠 PAGE의 항목 추출 모델을 원본, 8비트, 4비트로 각각 준비하고 동일한 검증 문서 800쪽으로 평가했습니다. 전체 정확도뿐 아니라 금액, 날짜, 이름, 주소처럼 항목 유형별 정확도를 따로 기록했습니다.
결과
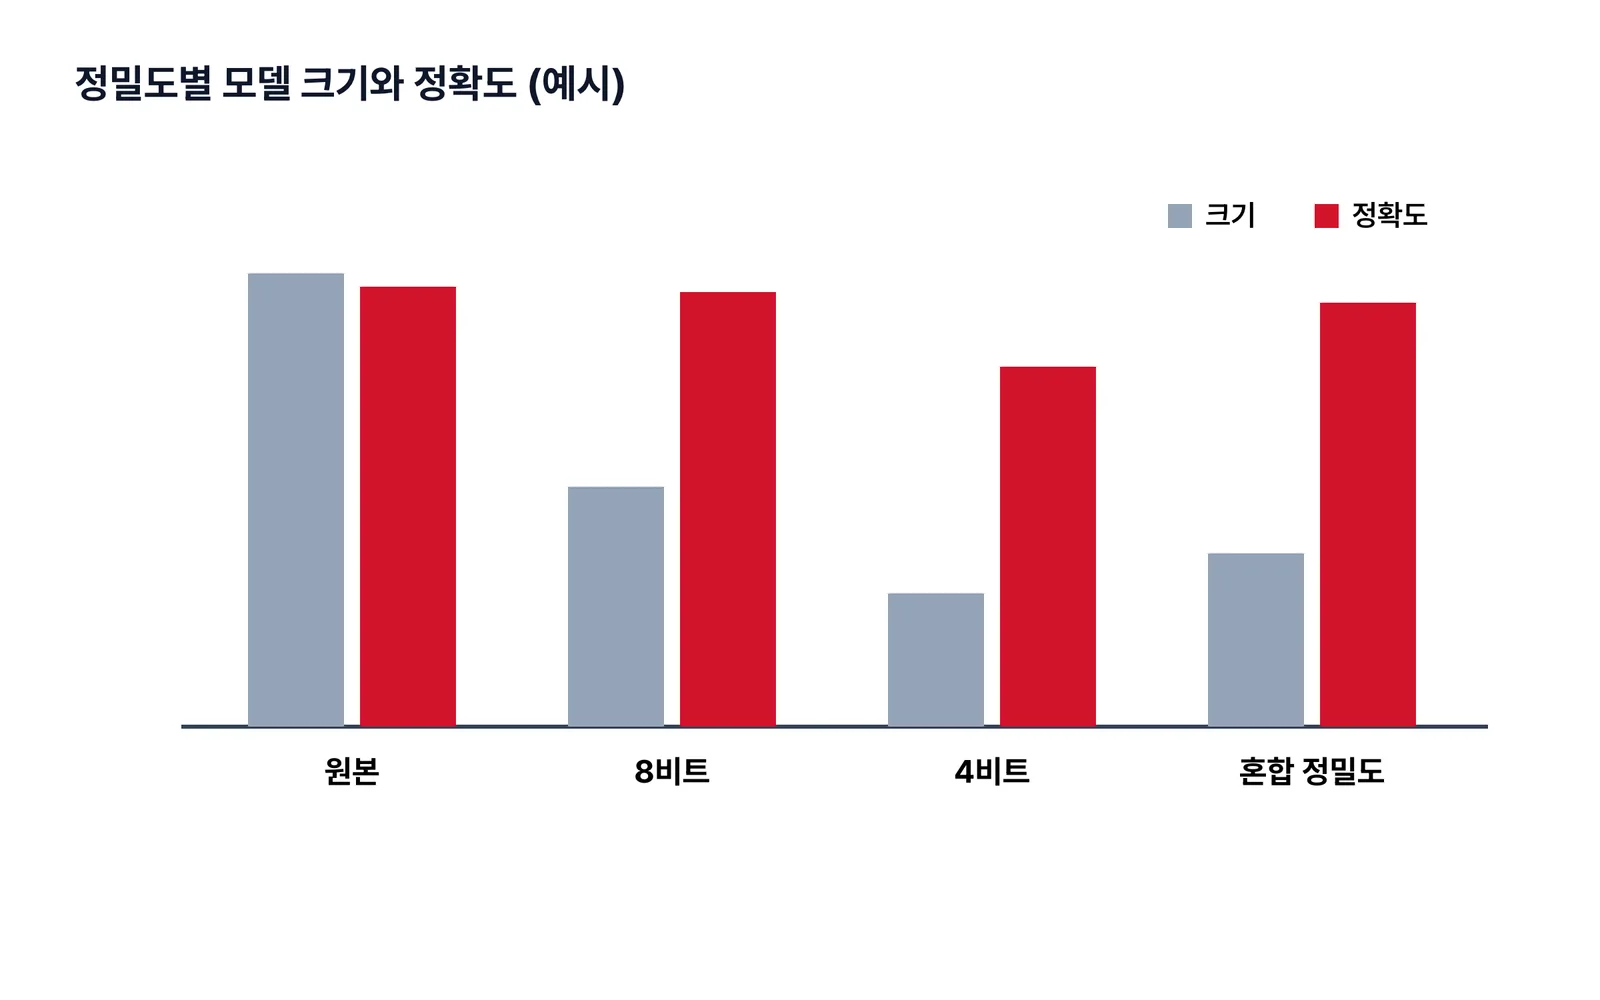
8비트에서는 대부분의 항목에서 차이가 거의 없었습니다. 4비트에서는 금액과 날짜 같은 숫자 항목의 정확도가 먼저 떨어졌고, 이름과 주소 항목은 상대적으로 잘 유지되었습니다(예시 데이터).
어느 층이 민감한가
층별로 하나씩 정밀도를 되돌려 보니 글자 이미지를 처음 받아들이는 초기 층과 숫자 위치를 판단하는 마지막 층이 손실에 가장 민감했습니다. 두 구간만 8비트로 남기고 나머지를 4비트로 줄인 혼합 방식이 크기와 정확도의 균형을 가장 잘 맞췄습니다.
현장 적용 기준
우리는 경량화 모델을 배포하기 전에 고객의 검증 데이터로 항목 유형별 손실을 측정하고, 손실이 합의된 기준을 넘는 항목이 있으면 해당 항목만 서버에서 다시 확인하도록 구성합니다. 경량화 리포트는 이 측정 결과를 그대로 담습니다.
다음 단계
음성 모델에서도 같은 측정 방식을 적용해 인식 오류가 늘어나는 발화 유형을 분석할 예정입니다.